
يبدأ كثير من المطورين مشاريعهم مع واجهات الذكاء الاصطناعي البرمجية بحماس، ثم تصلهم الفاتورة الأولى بعد إطلاق المنتج فيكتشفون أن التكلفة أعلى بكثير مما توقعوا. والسبب في الغالب ليس سعر النموذج بحد ذاته، بل طريقة الاستخدام: سياق يُرسل كاملًا مع كل رسالة، ونموذج ضخم يُستخدم لمهام بسيطة، وإجابات أطول من اللازم. في هذا الدليل من سلسلة تطوير تطبيقات الذكاء الاصطناعي سنشرح كيف تُحسب التكلفة، ثم نستعرض أساليب عملية لتقليل استهلاك التوكنز قد تخفض فاتورتك الشهرية إلى النصف أو أكثر دون أن يشعر المستخدم بأي فرق في الجودة.
ومن المهم أن يعرف المطور العربي أن النص العربي يستهلك غالبًا عددًا أكبر من التوكنز مقارنة بنص إنجليزي بالمعنى نفسه في كثير من النماذج، لأن أدوات التقطيع صُممت في الأصل مع تركيز أكبر على الإنجليزية، وإن كانت النماذج الحديثة قد حسّنت ذلك كثيرًا. لهذا فإن قياس استهلاك التوكنز على بياناتك الفعلية أهم من الاعتماد على تقديرات عامة.
خلاصة الأمر أن خفض استهلاك التوكنز ليس حيلة واحدة بل مجموعة عادات هندسية: نموذج مناسب لكل مهمة، وسياق نظيف ومرتب، وإجابات بالطول المطلوب، ومراقبة مستمرة. هذا الموضوع جزء من سلسلة تطوير تطبيقات الذكاء الاصطناعي في المنتدى، فشاركنا في الردود: ما أكثر شيء كان يرفع فاتورتك، وكيف تعاملت معه؟
كيف يُحسب استهلاك التوكنز في AI APIs؟
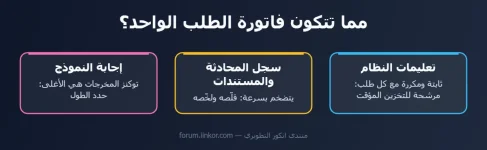
التوكن هو وحدة النص التي يتعامل بها النموذج، وقد يكون كلمة كاملة أو جزءًا من كلمة أو علامة ترقيم. وتُحسب الفاتورة على نوعين من التوكنز: توكنز المدخلات وهي كل ما ترسله للنموذج من تعليمات النظام وسجل المحادثة والمستندات والسؤال، وتوكنز المخرجات وهي ما يكتبه النموذج في الرد، وسعرها عادة أعلى بعدة مرات من سعر المدخلات.ومن المهم أن يعرف المطور العربي أن النص العربي يستهلك غالبًا عددًا أكبر من التوكنز مقارنة بنص إنجليزي بالمعنى نفسه في كثير من النماذج، لأن أدوات التقطيع صُممت في الأصل مع تركيز أكبر على الإنجليزية، وإن كانت النماذج الحديثة قد حسّنت ذلك كثيرًا. لهذا فإن قياس استهلاك التوكنز على بياناتك الفعلية أهم من الاعتماد على تقديرات عامة.
اختر النموذج المناسب لكل مهمة
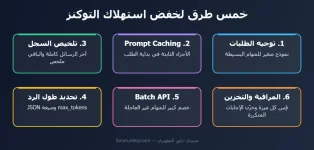
أكبر توفير في استهلاك التوكنز يأتي من هنا. ليس كل طلب يحتاج إلى أقوى نموذج متاح؛ فتصنيف رسالة أو استخراج اسم ورقم هاتف من نص أو ترجمة جملة قصيرة مهام تنجزها النماذج الصغيرة والسريعة بجودة ممتازة وبجزء بسيط من السعر. الأسلوب الذي تتبعه الأنظمة الاحترافية هو التوجيه (Routing): طبقة بسيطة تقرر نوع الطلب وترسله إلى النموذج المناسب، فتذهب المهام الصعبة إلى النموذج الكبير والباقي إلى النموذج الصغير. في كثير من التطبيقات تكون غالبية الطلبات من النوع البسيط، وهنا يظهر حجم التوفير، وهو مبدأ أساسي في تطوير تطبيقات الذكاء الاصطناعي بتكلفة معقولة.استفد من التخزين المؤقت للتعليمات
إذا كانت تطبيقاتك ترسل التعليمات الطويلة نفسها أو المستند نفسه مع كل طلب، فإن معظم مزودي النماذج الكبار يوفرون اليوم ميزة التخزين المؤقت للسياق (Prompt Caching)، حيث تُحسب الأجزاء المكررة من بداية الطلب بسعر مخفض جدًا عند إعادة استخدامها خلال فترة قصيرة. والشرط الأساسي للاستفادة منها هو ترتيب الطلب بذكاء: ضع الأجزاء الثابتة مثل تعليمات النظام والأمثلة والمستندات في البداية، وضع الأجزاء المتغيرة مثل سؤال المستخدم في النهاية، لأن التخزين يعمل على البادئة المتطابقة.قلّص السياق قبل إرساله
في تطبيقات المحادثة يتضخم السجل مع كل رسالة، وإذا أرسلته كاملًا في كل مرة فإن استهلاك التوكنز ينمو بشكل متسارع. الحل أن تحتفظ بآخر عدد محدود من الرسائل كما هي، وتستبدل الرسائل الأقدم بملخص قصير يكتبه نموذج صغير. وفي أنظمة الاسترجاع من الملفات، أرسل المقاطع الأكثر صلة فقط بدل عشرات المقاطع "احتياطًا". كذلك راجع تعليمات النظام نفسها، فكثيرًا ما تحتوي على فقرات مكررة أو أمثلة لم تعد ضرورية.Python:
def trim_history(messages, keep_last=6, summarizer=None):
    """أبقِ آخر الرسائل كما هي واختصر الأقدم في ملخص واحد"""
    if len(messages) <= keep_last:
        return messages
    old, recent = messages[:-keep_last], messages[-keep_last:]
    summary = summarizer("\n".join(m["content"] for m in old))  # نموذج صغير ورخيص
    return [{"role": "system", "content": f"ملخص المحادثة السابقة: {summary}"}] + recent
تحكّم في طول الإجابات واستخدم الدفعات
لأن توكنز المخرجات هي الأغلى، فإن تحديد طول الرد له أثر كبير على استهلاك التوكنز. اطلب في التعليمات إجابات مختصرة حين يكون ذلك مناسبًا، واستخدم معامل الحد الأقصى للتوكنز كسقف أمان، واطلب صيغة JSON محددة بدل نص حر طويل حين تحتاج بيانات منظمة. أما المهام التي لا تحتاج إلى رد فوري، مثل معالجة آلاف أوصاف المنتجات أو تحليل أرشيف من التقييمات، فاستخدم واجهات المعالجة بالدفعات (Batch API) التي يقدمها كثير من المزودين بخصم كبير مقابل تسليم النتائج خلال ساعات بدل ثوانٍ.راقب ثم حسّن
لا يمكنك تحسين ما لا تقيسه. سجّل لكل طلب عدد توكنز المدخلات والمخرجات والنموذج المستخدم والميزة التي أطلقت الطلب، وستكتشف غالبًا أن ميزة واحدة أو مستخدمًا واحدًا مسؤول عن جزء كبير من الفاتورة. ضع حدودًا للإنفاق وتنبيهات في لوحة المزود، وحدودًا لعدد الطلبات لكل مستخدم لحماية نفسك من الإساءة. وتذكر أن تخزين الإجابات المتكررة في قاعدة بياناتك، مثل إجابات الأسئلة الشائعة، يلغي الحاجة إلى استدعاء النموذج أصلًا.خلاصة الأمر أن خفض استهلاك التوكنز ليس حيلة واحدة بل مجموعة عادات هندسية: نموذج مناسب لكل مهمة، وسياق نظيف ومرتب، وإجابات بالطول المطلوب، ومراقبة مستمرة. هذا الموضوع جزء من سلسلة تطوير تطبيقات الذكاء الاصطناعي في المنتدى، فشاركنا في الردود: ما أكثر شيء كان يرفع فاتورتك، وكيف تعاملت معه؟
