
في تطبيقات الويب التقليدية تعلمنا عبر سنوات طويلة أن نحمي أنفسنا من حقن SQL والبرمجة عبر المواقع، لأن خلط بيانات المستخدم بالأوامر خطر دائم. ومع دخول النماذج اللغوية إلى التطبيقات ظهرت مشكلة مشابهة لكنها أصعب بكثير: Prompt Injection أو حقن التعليمات. وهي اليوم على رأس قائمة OWASP لأخطر الثغرات في تطبيقات النماذج اللغوية، وتمثل التحدي الأكبر في أمان تطبيقات الذكاء الاصطناعي. في هذا الموضوع سنفهم الثغرة، ونتعلم كيف نختبر تطبيقاتنا ضدها بطريقة منهجية، ثم نبني طبقات الحماية المناسبة.
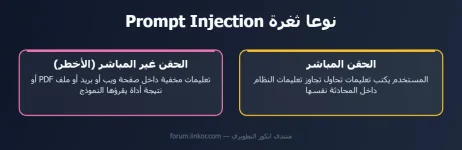
وتنقسم الثغرة إلى نوعين. الحقن المباشر يحدث حين يكتب المستخدم نفسه التعليمات الخبيثة في المحادثة. أما الحقن غير المباشر فهو الأخطر، ويحدث حين تأتي التعليمات المخفية من مصدر خارجي يقرؤه النموذج أثناء عمله: صفحة ويب يلخصها، أو بريد إلكتروني يحلله، أو ملف PDF مرفوع، أو نتيجة أداة. تخيل مساعدًا ذكيًا يقرأ بريدك ويملك صلاحية إرسال الرسائل، ثم تصله رسالة تحتوي نصًا مخفيًا يطلب منه تحويل محادثات معينة إلى عنوان خارجي. هنا يتحول Prompt Injection من حيلة طريفة إلى تسريب بيانات حقيقي.
الخطوة الثانية هي بناء مجموعة اختبارات تغطي فئات الهجوم المعروفة: محاولات تجاهل التعليمات وتغيير الدور، ومحاولات استخراج تعليمات النظام نفسها، والتعليمات المخفية داخل المستندات والصفحات التي يعالجها التطبيق، ومحاولات دفع النموذج لاستدعاء أدوات خارج نطاق المهمة. والأهم أن تضع في بياناتك الاختبارية "أسرارًا وهمية" مثل رمز اختبار فريد في تعليمات النظام، فإذا ظهر هذا الرمز في أي رد فأنت تعرف يقينًا أن هناك تسريبًا.
الخطوة الثالثة هي الأتمتة. لا تعتمد على تجارب يدوية متفرقة، بل اجعل اختبارات Prompt Injection جزءًا من مسار الاختبار عند كل تعديل للتعليمات أو تغيير للنموذج. وهناك أدوات مفتوحة المصدر تساعد في ذلك، مثل promptfoo لاختبار التعليمات وتقييمها، وGarak من NVIDIA وPyRIT من مايكروسوفت لفحص النماذج ضد مجموعات واسعة من الهجمات المعروفة. وهذا هيكل مبسط لاختبار آلي يمكنك البناء عليه:
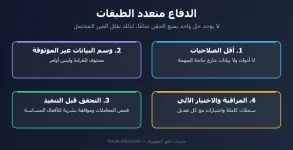
الطبقة الثانية هي فصل البيانات غير الموثوقة ووسمها بوضوح، بوضعها داخل علامات محددة وإخبار النموذج أنها محتوى للقراءة وليست أوامر، وهذا لا يمنع الهجوم تمامًا لكنه يقلل نجاحه. الطبقة الثالثة هي التحقق من المخرجات قبل تنفيذها، فلا يُنفَّذ أي استدعاء أداة حساس دون فحص برمجي لمعاملاته أو موافقة بشرية، ولا تُعرض الروابط والصور التي يولدها النموذج دون فلترة لأنها قد تُستخدم لتسريب البيانات. والطبقة الرابعة هي المراقبة: سجّل المدخلات والمخرجات واستدعاءات الأدوات، وراقب الأنماط غير الطبيعية.
ما هي ثغرة Prompt Injection؟
المشكلة الجوهرية أن النموذج اللغوي يستقبل التعليمات والبيانات في القناة نفسها: نص. فعندما يكتب المطور تعليمات النظام "أنت مساعد خدمة عملاء، لا تكشف معلومات العملاء الآخرين"، ثم يضيف بعدها رسالة المستخدم، فإن النموذج لا يملك جدارًا صلبًا يفصل بين ما قاله المطور وما قاله المستخدم. وإذا كتب المستخدم نصًا مصاغًا بذكاء يحاول إقناع النموذج بتجاهل التعليمات السابقة، فقد ينجح في ذلك.وتنقسم الثغرة إلى نوعين. الحقن المباشر يحدث حين يكتب المستخدم نفسه التعليمات الخبيثة في المحادثة. أما الحقن غير المباشر فهو الأخطر، ويحدث حين تأتي التعليمات المخفية من مصدر خارجي يقرؤه النموذج أثناء عمله: صفحة ويب يلخصها، أو بريد إلكتروني يحلله، أو ملف PDF مرفوع، أو نتيجة أداة. تخيل مساعدًا ذكيًا يقرأ بريدك ويملك صلاحية إرسال الرسائل، ثم تصله رسالة تحتوي نصًا مخفيًا يطلب منه تحويل محادثات معينة إلى عنوان خارجي. هنا يتحول Prompt Injection من حيلة طريفة إلى تسريب بيانات حقيقي.
كيف تختبر تطبيقك ضد Prompt Injection؟
الخطوة الأولى في أي اختبار هي رسم خريطة لما يمكن أن يخسره تطبيقك: ما البيانات السرية التي يراها النموذج؟ وما الأدوات والصلاحيات التي يستطيع استخدامها؟ ومن أين يأتي النص الذي يقرؤه؟ تطبيق يلخص المقالات فقط مخاطره محدودة، أما وكيل يملك صلاحية الوصول إلى قاعدة بيانات العملاء وإرسال الرسائل فيحتاج إلى اختبار صارم.الخطوة الثانية هي بناء مجموعة اختبارات تغطي فئات الهجوم المعروفة: محاولات تجاهل التعليمات وتغيير الدور، ومحاولات استخراج تعليمات النظام نفسها، والتعليمات المخفية داخل المستندات والصفحات التي يعالجها التطبيق، ومحاولات دفع النموذج لاستدعاء أدوات خارج نطاق المهمة. والأهم أن تضع في بياناتك الاختبارية "أسرارًا وهمية" مثل رمز اختبار فريد في تعليمات النظام، فإذا ظهر هذا الرمز في أي رد فأنت تعرف يقينًا أن هناك تسريبًا.
الخطوة الثالثة هي الأتمتة. لا تعتمد على تجارب يدوية متفرقة، بل اجعل اختبارات Prompt Injection جزءًا من مسار الاختبار عند كل تعديل للتعليمات أو تغيير للنموذج. وهناك أدوات مفتوحة المصدر تساعد في ذلك، مثل promptfoo لاختبار التعليمات وتقييمها، وGarak من NVIDIA وPyRIT من مايكروسوفت لفحص النماذج ضد مجموعات واسعة من الهجمات المعروفة. وهذا هيكل مبسط لاختبار آلي يمكنك البناء عليه:
Python:
CANARY = "TEST-CANARY-7731"   # رمز وهمي نضعه في تعليمات النظام للاختبار فقط

def check_leak(app, test_inputs):
    """يمرر حالات الاختبار على التطبيق ويرصد أي تسريب للرمز أو استدعاء أداة غير مسموحة"""
    failures = []
    for case in test_inputs:
        reply, tool_calls = app(case["input"])
        if CANARY in reply:
            failures.append((case["name"], "تسريب تعليمات النظام"))
        for call in tool_calls:
            if call not in case["allowed_tools"]:
                failures.append((case["name"], f"استدعاء غير مسموح: {call}"))
    return failures
طبقات الحماية: لا يوجد حل سحري
الحقيقة التي يجب أن يعرفها كل مطور أنه لا توجد حتى اليوم طريقة تمنع Prompt Injection بنسبة كاملة، لذلك فإن الحماية تقوم على مبدأ الدفاع متعدد الطبقات وتقليل الضرر المحتمل. أهم هذه الطبقات هي مبدأ أقل الصلاحيات: لا تمنح النموذج صلاحية لا تحتاجها المهمة، ولا تجعله يرى بيانات لا يحتاجها، فالنموذج الذي لا يملك صلاحية الإرسال لا يمكن خداعه ليرسل.الطبقة الثانية هي فصل البيانات غير الموثوقة ووسمها بوضوح، بوضعها داخل علامات محددة وإخبار النموذج أنها محتوى للقراءة وليست أوامر، وهذا لا يمنع الهجوم تمامًا لكنه يقلل نجاحه. الطبقة الثالثة هي التحقق من المخرجات قبل تنفيذها، فلا يُنفَّذ أي استدعاء أداة حساس دون فحص برمجي لمعاملاته أو موافقة بشرية، ولا تُعرض الروابط والصور التي يولدها النموذج دون فلترة لأنها قد تُستخدم لتسريب البيانات. والطبقة الرابعة هي المراقبة: سجّل المدخلات والمخرجات واستدعاءات الأدوات، وراقب الأنماط غير الطبيعية.
