
تعلمت النماذج اللغوية الكبيرة ما تعرفه من قراءة جزء هائل من النصوص التي كتبها البشر على الإنترنت وفي الكتب، لكن هذا المخزون ليس بلا نهاية. تقديرات باحثين في مؤسسات متخصصة مثل Epoch AI تشير إلى أن النصوص البشرية العامة عالية الجودة قد تُستنفد كمصدر للتدريب في وقت ما خلال السنوات القليلة القادمة إذا استمر النمو بالوتيرة الحالية. فمن أين ستتعلم النماذج القادمة؟ إحدى أكثر الإجابات تداولًا هي البيانات الاصطناعية (Synthetic Data)، أي بيانات تولدها النماذج نفسها أو برامج المحاكاة. لكن هل هي حل سحري فعلًا، أم أن تعليم الآلة من إنتاج الآلة يحمل مخاطر خفية؟
والفكرة ليست جديدة؛ فشركات السيارات ذاتية القيادة تعتمد منذ سنوات على المحاكاة لاختبار مواقف خطرة ونادرة يستحيل جمع ما يكفي منها في الواقع، مثل طفل يركض فجأة أمام السيارة في ليلة ممطرة. الجديد هو استخدامها على نطاق واسع في تدريب النماذج اللغوية الكبيرة.
وقد أظهرت تجارب عديدة نجاحًا حقيقيًا، خاصة في المجالات التي يمكن فيها التحقق من صحة البيانات آليًا. في الرياضيات والبرمجة مثلًا، يمكن للنموذج أن يولد حلولًا كثيرة، ثم يُفحص كل حل: هل الإجابة الرياضية صحيحة؟ هل يمر الكود من الاختبارات؟ فيُحتفظ بالحلول الصحيحة فقط للتدريب. وهذا أحد أسرار التحسن الكبير في قدرات الاستدلال لدى النماذج الحديثة.
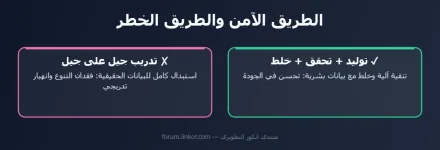
لكن من المهم قراءة هذه النتيجة بدقة: الانهيار يحدث بشكل أوضح حين تُستبدل البيانات الحقيقية بالكامل بالاصطناعية جيلًا بعد جيل دون تنقية. أما حين تُخلط البيانات الاصطناعية بالبيانات البشرية، وتُفحص وتُنقى بعناية، فإن النتائج تكون أفضل بكثير، وهذا ما تفعله المختبرات الجادة عمليًا.
وبالنسبة للغة العربية تحديدًا، التي تعاني من قلة المحتوى الرقمي عالي الجودة مقارنة بالإنجليزية، قد تكون البيانات الاصطناعية فرصة لسد الفجوة، أو خطرًا يرسخ ترجمات ركيكة وأسلوبًا غير طبيعي إذا لم تُستخدم بحذر. ما رأيك: هل يمكن أن تتعلم الآلة شيئًا جديدًا حقًا من إنتاج آلة أخرى؟ شاركنا رأيك في الردود.
ما هي البيانات الاصطناعية؟
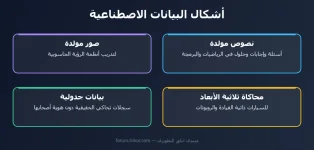
البيانات الاصطناعية هي أي بيانات لم تُجمع من العالم الحقيقي مباشرة، بل وُلدت بشكل مصطنع لتحاكي خصائص البيانات الحقيقية. قد تكون نصوصًا يكتبها نموذج لغوي، مثل آلاف الأسئلة والإجابات في الرياضيات أو البرمجة، أو صورًا مولدة لتدريب أنظمة الرؤية، أو بيانات جدولية تحاكي سجلات مرضى أو معاملات بنكية دون أن تعود لأشخاص حقيقيين، أو مشاهد محاكاة ثلاثية الأبعاد لتدريب السيارات ذاتية القيادة والروبوتات.والفكرة ليست جديدة؛ فشركات السيارات ذاتية القيادة تعتمد منذ سنوات على المحاكاة لاختبار مواقف خطرة ونادرة يستحيل جمع ما يكفي منها في الواقع، مثل طفل يركض فجأة أمام السيارة في ليلة ممطرة. الجديد هو استخدامها على نطاق واسع في تدريب النماذج اللغوية الكبيرة.
لماذا تبدو البيانات الاصطناعية حلًا جذابًا؟
الميزة الأولى هي الوفرة والتحكم: تستطيع توليد ملايين الأمثلة في المجال الذي تريده بالضبط، وبمستوى الصعوبة المطلوب، بدل انتظار ما يتوفر في العالم. والثانية هي الخصوصية، فبيانات طبية اصطناعية تحافظ على الأنماط الإحصائية للبيانات الحقيقية تتيح للباحثين العمل دون كشف هوية المرضى. والثالثة هي تغطية الحالات النادرة، كأمثلة الاحتيال المالي التي تكون قليلة جدًا في البيانات الحقيقية. والرابعة هي التكلفة، فتوليد البيانات أرخص كثيرًا في حالات عديدة من جمعها وتصنيفها يدويًا.وقد أظهرت تجارب عديدة نجاحًا حقيقيًا، خاصة في المجالات التي يمكن فيها التحقق من صحة البيانات آليًا. في الرياضيات والبرمجة مثلًا، يمكن للنموذج أن يولد حلولًا كثيرة، ثم يُفحص كل حل: هل الإجابة الرياضية صحيحة؟ هل يمر الكود من الاختبارات؟ فيُحتفظ بالحلول الصحيحة فقط للتدريب. وهذا أحد أسرار التحسن الكبير في قدرات الاستدلال لدى النماذج الحديثة.
الوجه الآخر: خطر انهيار النماذج
نشر باحثون في مجلة Nature عام 2024 دراسة لفتت الانتباه إلى ظاهرة سموها "انهيار النموذج" (Model Collapse). الفكرة أنك إذا دربت نموذجًا على بيانات ولدها نموذج سابق، ثم دربت الجيل التالي على بيانات الجيل الثاني، وهكذا، فإن النماذج تبدأ بفقدان التنوع تدريجيًا، فتختفي الحالات النادرة والأطراف من التوزيع، وتصبح المخرجات أكثر تكرارًا وتشابهًا، وقد تتراكم الأخطاء حتى تتدهور الجودة بشكل واضح. يشبه الأمر نسخ صورة من نسخة من نسخة، فكل جيل يفقد شيئًا من التفاصيل.لكن من المهم قراءة هذه النتيجة بدقة: الانهيار يحدث بشكل أوضح حين تُستبدل البيانات الحقيقية بالكامل بالاصطناعية جيلًا بعد جيل دون تنقية. أما حين تُخلط البيانات الاصطناعية بالبيانات البشرية، وتُفحص وتُنقى بعناية، فإن النتائج تكون أفضل بكثير، وهذا ما تفعله المختبرات الجادة عمليًا.
مشكلة إضافية: الإنترنت نفسه يتغير
هناك تحدٍ أقل وضوحًا: الإنترنت الذي ستُجمع منه بيانات المستقبل يمتلئ تدريجيًا بمحتوى مولد آليًا، من المقالات إلى التعليقات والصور. وهذا يعني أن البيانات "البشرية" نفسها لم تعد بشرية خالصة، وأن البيانات التي جُمعت قبل انتشار النماذج التوليدية أصبحت أكثر قيمة. ولهذا تتسابق الشركات على اتفاقيات ترخيص مع الناشرين ومنصات المحتوى للحصول على بيانات بشرية موثوقة، وتزداد أهمية تقنيات تمييز المحتوى المولد آليًا.هل البيانات الاصطناعية حل سحري؟
الإجابة المتوازنة: هي أداة قوية وليست سحرًا. تنجح بوضوح حين يمكن التحقق من جودة البيانات، وحين تُستخدم لسد فجوات محددة، وحين تُخلط مع بيانات حقيقية. وتصبح خطرة حين تُستخدم بلا تنقية أو كبديل كامل للواقع. ومن المرجح أن يعتمد مستقبل الذكاء الاصطناعي على مزيج من البيانات الاصطناعية المنقاة، والبيانات البشرية المرخصة، والتعلم من التفاعل مع العالم الحقيقي عبر الروبوتات والمحاكاة.وبالنسبة للغة العربية تحديدًا، التي تعاني من قلة المحتوى الرقمي عالي الجودة مقارنة بالإنجليزية، قد تكون البيانات الاصطناعية فرصة لسد الفجوة، أو خطرًا يرسخ ترجمات ركيكة وأسلوبًا غير طبيعي إذا لم تُستخدم بحذر. ما رأيك: هل يمكن أن تتعلم الآلة شيئًا جديدًا حقًا من إنتاج آلة أخرى؟ شاركنا رأيك في الردود.
