
عندما تبحث في متجر إلكتروني عن "حذاء مريح للمشي الطويل" وتظهر لك نتائج لا تحتوي هذه الكلمات حرفيًا لكنها مناسبة تمامًا لطلبك، فعلى الأغلب هناك قواعد البيانات المتجهة تعمل خلف الكواليس. هذا النوع من قواعد البيانات انتقل خلال سنوات قليلة من مجال بحثي متخصص إلى مكوّن أساسي في معظم مشاريع تطوير تطبيقات الذكاء الاصطناعي، من أنظمة الإجابة من الملفات إلى محركات التوصية والبحث الذكي. في هذا الموضوع سنفهم ما هي المتجهات أصلًا، وكيف تعمل هذه القواعد، ومتى تحتاجها فعلًا ومتى يكفيك ما لديك.
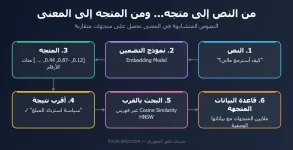
بهذه الفكرة يتحول سؤال "ما أقرب المستندات معنى إلى هذا السؤال؟" إلى سؤال رياضي: ما أقرب النقاط إلى هذه النقطة؟ ويُقاس القرب عادة بمقياس تشابه جيب التمام (Cosine Similarity) أو بالمسافة الإقليدية.
وإلى جانب السرعة توفر قواعد البيانات المتجهة ميزات مهمة للتطبيقات الحقيقية، مثل تخزين بيانات وصفية مع كل متجه (اسم الملف، القسم، التاريخ، صلاحيات الوصول)، والتصفية بها أثناء البحث، والبحث الهجين الذي يجمع بين المعنى والكلمات المفتاحية.
الفئة الثانية قواعد مفتوحة المصدر متخصصة مثل Qdrant وMilvus وWeaviate وChroma؛ فـChroma خفيفة جدًا ومناسبة للتجارب والنماذج الأولية، وQdrant تتميز بالأداء العالي وقوة التصفية، وMilvus مصممة للأحجام الضخمة جدًا. أما الفئة الثالثة فهي الخدمات السحابية المُدارة مثل Pinecone، التي تريحك من إدارة السيرفرات مقابل اشتراك شهري.
لاحظ أن Chroma هنا تستخدم نموذج تضمين افتراضيًا، وفي المشاريع العربية الحقيقية يُنصح باختيار نموذج متعدد اللغات قوي في العربية، لأن جودة النموذج هي ما يحدد جودة البحث في النهاية وليس قاعدة البيانات.
لماذا إذًا أصبحت قواعد البيانات المتجهة العمود الفقري لتطبيقات الذكاء الاصطناعي؟ لأنها الجسر الذي يربط النماذج اللغوية ببيانات العالم الحقيقي، فتمنحها ذاكرة طويلة قابلة للبحث بالمعنى. هذا الموضوع جزء من سلسلة تطوير تطبيقات الذكاء الاصطناعي، ويكمّله شرح نظام RAG خطوة بخطوة. أي قاعدة بيانات متجهة تستخدم في مشاريعك، ولماذا اخترتها؟
ما هو المتجه (Embedding)؟
الحاسوب لا يفهم المعنى، بل يفهم الأرقام. لذلك تُستخدم نماذج خاصة تسمى نماذج التضمين (Embedding Models) تحول أي نص أو صورة إلى قائمة طويلة من الأرقام، قد تصل إلى مئات أو آلاف الأرقام، تمثل موقع هذا المحتوى في "فضاء المعاني". السر هنا أن النصوص المتشابهة في المعنى تحصل على متجهات قريبة من بعضها، حتى لو اختلفت كلماتها تمامًا. فجملة "كيف أسترجع مالي؟" ستكون قريبة من "سياسة استرداد المبلغ"، وبعيدة عن "أسعار الشحن الدولي".بهذه الفكرة يتحول سؤال "ما أقرب المستندات معنى إلى هذا السؤال؟" إلى سؤال رياضي: ما أقرب النقاط إلى هذه النقطة؟ ويُقاس القرب عادة بمقياس تشابه جيب التمام (Cosine Similarity) أو بالمسافة الإقليدية.
لماذا لا تكفي قواعد البيانات التقليدية؟
قواعد البيانات العلائقية مثل MySQL ممتازة في البحث عن قيمة محددة: المنتج رقم 15، أو العملاء في مدينة معينة. لكن البحث عن "أقرب مليون متجه" بطريقة مباشرة يعني مقارنة السؤال بكل سجل في القاعدة، وهذا بطيء جدًا عندما يصل عدد السجلات إلى الملايين. هنا يأتي دور قواعد البيانات المتجهة، فهي تبني فهارس خاصة مثل HNSW تنظم المتجهات في شبكة طبقية تسمح بالوصول إلى أقرب الجيران خلال أجزاء من الثانية، مقابل تنازل بسيط جدًا في الدقة يسمى البحث التقريبي (Approximate Nearest Neighbor).وإلى جانب السرعة توفر قواعد البيانات المتجهة ميزات مهمة للتطبيقات الحقيقية، مثل تخزين بيانات وصفية مع كل متجه (اسم الملف، القسم، التاريخ، صلاحيات الوصول)، والتصفية بها أثناء البحث، والبحث الهجين الذي يجمع بين المعنى والكلمات المفتاحية.
أشهر قواعد البيانات المتجهة وأيها تختار
خيارات قواعد البيانات المتجهة كثيرة، ويمكن تقسيمها بشكل عملي إلى ثلاث فئات. الفئة الأولى إضافات على قواعد بيانات تعرفها أصلًا، وأشهرها pgvector لقاعدة PostgreSQL، وهي خيار ممتاز إذا كان مشروعك يستخدم PostgreSQL بالفعل وحجم بياناتك متوسط، لأنك تحتفظ بكل شيء في مكان واحد وتستطيع دمج البحث بالمعنى مع استعلامات SQL العادية.الفئة الثانية قواعد مفتوحة المصدر متخصصة مثل Qdrant وMilvus وWeaviate وChroma؛ فـChroma خفيفة جدًا ومناسبة للتجارب والنماذج الأولية، وQdrant تتميز بالأداء العالي وقوة التصفية، وMilvus مصممة للأحجام الضخمة جدًا. أما الفئة الثالثة فهي الخدمات السحابية المُدارة مثل Pinecone، التي تريحك من إدارة السيرفرات مقابل اشتراك شهري.
مثال سريع مع Chroma
لنرَ كيف يبدو العمل مع قواعد البيانات المتجهة عمليًا. في هذا المثال نضيف ثلاثة نصوص ثم نبحث بسؤال لا يحتوي على كلماتها نفسها:Python:
import chromadb

client = chromadb.PersistentClient(path="./vectors")
col = client.get_or_create_collection("faq")

col.add(
    ids=["1", "2", "3"],
    documents=["يمكنك استرداد المبلغ خلال 14 يومًا من الاستلام",
               "الشحن الدولي يستغرق من 7 إلى 10 أيام عمل",
               "نقبل الدفع عند الاستلام داخل المدن الرئيسية"],
    metadatas=[{"section": "returns"}, {"section": "shipping"}, {"section": "payment"}],
)

result = col.query(query_texts=["كيف أرجع فلوسي؟"], n_results=1)
print(result["documents"][0])  # ← نص سياسة الاسترداد
لاحظ أن Chroma هنا تستخدم نموذج تضمين افتراضيًا، وفي المشاريع العربية الحقيقية يُنصح باختيار نموذج متعدد اللغات قوي في العربية، لأن جودة النموذج هي ما يحدد جودة البحث في النهاية وليس قاعدة البيانات.
هل تحتاج فعلًا إلى قاعدة بيانات متجهة؟
ليس دائمًا. إذا كان لديك بضعة آلاف من المستندات فقط، فقد يكفي حفظ المتجهات في ملف والبحث فيها بمكتبة مثل FAISS أو حتى بحساب مباشر، أو إضافة pgvector إلى قاعدتك الحالية. القاعدة المتخصصة تصبح ضرورية مع ملايين المتجهات، أو حين تحتاج تصفية معقدة وتحديثات مستمرة وتوزيعًا على عدة سيرفرات. والخطأ الشائع هو إضافة قاعدة جديدة إلى البنية التحتية قبل الحاجة إليها، مما يزيد التعقيد وتكاليف الصيانة دون فائدة حقيقية.لماذا إذًا أصبحت قواعد البيانات المتجهة العمود الفقري لتطبيقات الذكاء الاصطناعي؟ لأنها الجسر الذي يربط النماذج اللغوية ببيانات العالم الحقيقي، فتمنحها ذاكرة طويلة قابلة للبحث بالمعنى. هذا الموضوع جزء من سلسلة تطوير تطبيقات الذكاء الاصطناعي، ويكمّله شرح نظام RAG خطوة بخطوة. أي قاعدة بيانات متجهة تستخدم في مشاريعك، ولماذا اخترتها؟
