
لو سألت أي نموذج ذكاء اصطناعي عام عن سياسة الاسترجاع في متجرك، أو عن بند محدد في عقد شركتك، أو عن رصيد عميل في قاعدة بياناتك، فإنه سيجيبك بثقة لكن من خياله، لأنه ببساطة لم يرَ هذه البيانات يومًا. هنا يأتي دور نظام RAG (اختصار Retrieval-Augmented Generation أي التوليد المعزّز بالاسترجاع)، وهو اليوم الأسلوب الأكثر انتشارًا في تطوير تطبيقات الذكاء الاصطناعي التي تحتاج إلى أن تجيب من مصادر محددة وموثوقة بدل الاعتماد على ذاكرة النموذج العامة. في هذا الشرح سنفهم الفكرة من أساسها، ثم نبني معًا مثالًا عمليًا خطوة بخطوة.
بهذه الطريقة نحصل على ثلاث فوائد مباشرة. الأولى أن الإجابات تصبح مبنية على بياناتك الفعلية وليس على معلومات عامة قد تكون قديمة. الثانية أن تحديث المعرفة لا يحتاج إلى إعادة تدريب النموذج؛ يكفي أن تضيف الملف الجديد إلى قاعدة المعرفة ليصبح متاحًا فورًا. والثالثة أنك تستطيع أن تعرض للمستخدم المصدر الذي استُخرجت منه الإجابة، فيتحقق منها بنفسه، وهذا أمر حاسم في المجالات القانونية والطبية والمالية وخدمة العملاء.
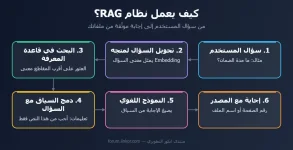
المرحلة الثانية هي الاسترجاع والتوليد، وتتكرر مع كل سؤال: يُحوَّل سؤال المستخدم إلى متجه بالنموذج نفسه، ثم يُبحث في القاعدة عن أقرب المقاطع معنى إليه، وتُدمج هذه المقاطع مع السؤال في تعليمات واضحة تُرسل إلى النموذج اللغوي، فيكتب الإجابة معتمدًا عليها. الجميل هنا أن البحث يتم بالمعنى لا بالكلمات الحرفية؛ فلو سأل المستخدم عن "إرجاع المنتج" سيجد النظام الفقرة التي تتحدث عن "سياسة الاستبدال والاسترداد" حتى لو لم تتطابق الكلمات.
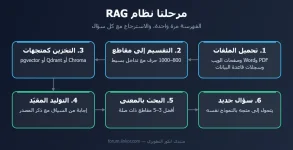
الخطوة الأولى هي تحميل الملفات وتقسيمها. حجم المقطع من أهم القرارات في أي نظام RAG؛ فالمقطع الكبير جدًا يُدخل معلومات لا علاقة لها بالسؤال ويستهلك التوكنز، والصغير جدًا يقطع الفكرة من منتصفها. نقطة بداية جيدة هي 800 إلى 1000 حرف مع تداخل يقارب 150 حرفًا بين كل مقطع والذي يليه:
الخطوة الثانية هي تحويل المقاطع إلى متجهات وتخزينها. يكفي تنفيذ هذا الجزء مرة واحدة، لأن Chroma تحفظ القاعدة على القرص في المجلد الذي تحدده:
الخطوة الثالثة هي قلب نظام RAG: استرجاع أقرب المقاطع للسؤال ثم صياغة التعليمات بحيث تُلزم النموذج بالإجابة من السياق فقط. لاحظ أننا نطلب منه صراحة الاعتراف بعدم المعرفة، وذكر رقم الصفحة، فهذا يقلل الهلوسة بشكل ملحوظ:
بهذه الأسطر القليلة أصبح لديك مساعد يجيب من ملفاتك أنت. وإذا كانت بياناتك في قاعدة بيانات وليست في ملفات، فالمبدأ نفسه تمامًا: تستخرج السجلات النصية (أوصاف المنتجات، الأسئلة الشائعة، تذاكر الدعم القديمة) وتحولها إلى مقاطع وتخزن متجهاتها، أما البيانات الرقمية الدقيقة مثل الأرصدة والأسعار فالأفضل جلبها باستعلام SQL مباشر وإضافتها إلى السياق، لأن البحث بالمعنى ليس مصممًا للأرقام.
ومع نمو المشروع يمكنك تحسين الدقة بإضافة مرحلة إعادة ترتيب (Re-ranking) تعيد تقييم المقاطع المسترجعة وتختار أدقها، أو بالبحث الهجين الذي يجمع بين البحث بالمعنى والبحث بالكلمات المفتاحية، وهذا مفيد خصوصًا عندما تحتوي الأسئلة على أسماء منتجات أو أرقام موديلات لا تلتقطها المتجهات جيدًا.
جرّب المثال على مجموعة صغيرة من ملفاتك، واكتب لنا في الردود: ما نوع البيانات التي تريد أن يجيب منها مساعدك الذكي؟ وما أكبر تحدٍّ واجهته مع الملفات العربية؟ سنكمل في مواضيع قادمة من سلسلة تطوير تطبيقات الذكاء الاصطناعي بشرح قواعد البيانات المتجهة بالتفصيل.
ما هو نظام RAG ولماذا نحتاجه؟
النموذج اللغوي الكبير يشبه طالبًا متفوقًا قرأ ملايين الكتب حتى تاريخ معين ثم أُغلقت عليه المكتبة. هو بارع في الصياغة والفهم والاستنتاج، لكنه لا يعرف شيئًا عن ملفاتك الداخلية، ولا عمّا حدث بعد تاريخ تدريبه، وإذا لم يعرف الإجابة فقد يختلقها بأسلوب مقنع. فكرة نظام RAG بسيطة وذكية في الوقت نفسه: بدل أن نطلب من الطالب الإجابة من ذاكرته، نضع أمامه قبل كل سؤال الصفحات المناسبة من ملفاتنا ونقول له: أجب من هذه النصوص فقط، وإن لم تجد الجواب فيها فقل لا أعرف.بهذه الطريقة نحصل على ثلاث فوائد مباشرة. الأولى أن الإجابات تصبح مبنية على بياناتك الفعلية وليس على معلومات عامة قد تكون قديمة. الثانية أن تحديث المعرفة لا يحتاج إلى إعادة تدريب النموذج؛ يكفي أن تضيف الملف الجديد إلى قاعدة المعرفة ليصبح متاحًا فورًا. والثالثة أنك تستطيع أن تعرض للمستخدم المصدر الذي استُخرجت منه الإجابة، فيتحقق منها بنفسه، وهذا أمر حاسم في المجالات القانونية والطبية والمالية وخدمة العملاء.
كيف يعمل نظام RAG من الداخل؟
يمر أي نظام RAG بمرحلتين منفصلتين. المرحلة الأولى هي الفهرسة، وتتم مرة واحدة أو كلما أضفت ملفات جديدة: تُقرأ المستندات وتُقسَّم إلى مقاطع صغيرة متداخلة قليلًا، ثم يُحوَّل كل مقطع إلى متجه رقمي (Embedding) يمثل معناه، وتُخزَّن هذه المتجهات في قاعدة بيانات متجهة مثل Chroma أو Qdrant أو pgvector داخل PostgreSQL.المرحلة الثانية هي الاسترجاع والتوليد، وتتكرر مع كل سؤال: يُحوَّل سؤال المستخدم إلى متجه بالنموذج نفسه، ثم يُبحث في القاعدة عن أقرب المقاطع معنى إليه، وتُدمج هذه المقاطع مع السؤال في تعليمات واضحة تُرسل إلى النموذج اللغوي، فيكتب الإجابة معتمدًا عليها. الجميل هنا أن البحث يتم بالمعنى لا بالكلمات الحرفية؛ فلو سأل المستخدم عن "إرجاع المنتج" سيجد النظام الفقرة التي تتحدث عن "سياسة الاستبدال والاسترداد" حتى لو لم تتطابق الكلمات.
بناء نظام RAG خطوة بخطوة بلغة Python
سنبني مثالًا مصغرًا يقرأ مجلدًا من ملفات PDF ويجيب عن الأسئلة منها. سنستخدم مكتبة LangChain لتنظيم الخطوات، وقاعدة Chroma لتخزين المتجهات محليًا، ويمكنك استبدال مزود النموذج بأي خدمة تفضلها أو بنموذج محلي عبر Ollama. ابدأ بتثبيت المكتبات المطلوبة:Bash:
pip install langchain langchain-community langchain-openai langchain-chroma pypdfالخطوة الأولى هي تحميل الملفات وتقسيمها. حجم المقطع من أهم القرارات في أي نظام RAG؛ فالمقطع الكبير جدًا يُدخل معلومات لا علاقة لها بالسؤال ويستهلك التوكنز، والصغير جدًا يقطع الفكرة من منتصفها. نقطة بداية جيدة هي 800 إلى 1000 حرف مع تداخل يقارب 150 حرفًا بين كل مقطع والذي يليه:
Python:
from langchain_community.document_loaders import PyPDFDirectoryLoader

from langchain.text_splitter import RecursiveCharacterTextSplitter

docs = PyPDFDirectoryLoader("./my_docs").load()

splitter = RecursiveCharacterTextSplitter(chunk_size=900, chunk_overlap=150)

chunks = splitter.split_documents(docs)

print(f"عدد المقاطع: {len(chunks)}")
الخطوة الثانية هي تحويل المقاطع إلى متجهات وتخزينها. يكفي تنفيذ هذا الجزء مرة واحدة، لأن Chroma تحفظ القاعدة على القرص في المجلد الذي تحدده:
Python:
from langchain_openai import OpenAIEmbeddings

from langchain_chroma import Chroma

embeddings = OpenAIEmbeddings(model="text-embedding-3-small")

db = Chroma.from_documents(chunks, embeddings, persist_directory="./chroma_db")
الخطوة الثالثة هي قلب نظام RAG: استرجاع أقرب المقاطع للسؤال ثم صياغة التعليمات بحيث تُلزم النموذج بالإجابة من السياق فقط. لاحظ أننا نطلب منه صراحة الاعتراف بعدم المعرفة، وذكر رقم الصفحة، فهذا يقلل الهلوسة بشكل ملحوظ:
Python:
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)

retriever = db.as_retriever(search_kwargs={"k": 4})

def ask(question):

    hits = retriever.invoke(question)

    context = "\n\n".join(f"[صفحة {d.metadata.get('page')}] {d.page_content}" for d in hits)

    prompt = f"""أجب عن السؤال اعتمادًا على السياق التالي فقط.

إذا لم تجد الإجابة في السياق فقل: لا تتوفر هذه المعلومة في المستندات.

اذكر رقم الصفحة التي اعتمدت عليها.

السياق:

{context}

السؤال: {question}"""

    return llm.invoke(prompt).content

print(ask("ما هي مدة الضمان على الأجهزة؟"))
بهذه الأسطر القليلة أصبح لديك مساعد يجيب من ملفاتك أنت. وإذا كانت بياناتك في قاعدة بيانات وليست في ملفات، فالمبدأ نفسه تمامًا: تستخرج السجلات النصية (أوصاف المنتجات، الأسئلة الشائعة، تذاكر الدعم القديمة) وتحولها إلى مقاطع وتخزن متجهاتها، أما البيانات الرقمية الدقيقة مثل الأرصدة والأسعار فالأفضل جلبها باستعلام SQL مباشر وإضافتها إلى السياق، لأن البحث بالمعنى ليس مصممًا للأرقام.
أخطاء شائعة تُضعف نتائج نظام RAG
أكثر ما يُفسد التجربة هو تقسيم المستندات بشكل عشوائي يفصل العنوان عن محتواه أو الجدول عن شرحه، لذلك يستحق الأمر أن تنظر بعينك إلى عينة من المقاطع قبل تخزينها. الخطأ الثاني هو استخدام نموذج Embedding ضعيف في اللغة العربية؛ فبعض النماذج المجانية القديمة تفهم الإنجليزية جيدًا لكنها تتعثر مع العربية، فجرّب نماذج متعددة اللغات مثل bge-m3 أو multilingual-e5 وقارن النتائج على أسئلة حقيقية. الخطأ الثالث هو استرجاع عدد كبير من المقاطع ظنًا أن المزيد أفضل، بينما الواقع أن السياق المزدحم يشتت النموذج ويرفع التكلفة.ومع نمو المشروع يمكنك تحسين الدقة بإضافة مرحلة إعادة ترتيب (Re-ranking) تعيد تقييم المقاطع المسترجعة وتختار أدقها، أو بالبحث الهجين الذي يجمع بين البحث بالمعنى والبحث بالكلمات المفتاحية، وهذا مفيد خصوصًا عندما تحتوي الأسئلة على أسماء منتجات أو أرقام موديلات لا تلتقطها المتجهات جيدًا.
متى يكون نظام RAG هو الخيار الصحيح؟
إذا كانت مشكلتك أن النموذج لا يعرف معلومات محددة تتغير باستمرار، مثل دليل منتجاتك أو لوائح شركتك أو أرشيف مقالاتك، فإن نظام RAG هو الحل الأنسب والأقل تكلفة في الغالب. أما إذا كانت المشكلة في أسلوب النموذج أو طريقة كتابته أو التزامه بصيغة معينة، فقد يكون الضبط الدقيق أو تحسين التعليمات هو الأنسب، وقد خصصنا لهذه المقارنة موضوعًا مستقلًا ضمن سلسلة تطوير تطبيقات الذكاء الاصطناعي في المنتدى.جرّب المثال على مجموعة صغيرة من ملفاتك، واكتب لنا في الردود: ما نوع البيانات التي تريد أن يجيب منها مساعدك الذكي؟ وما أكبر تحدٍّ واجهته مع الملفات العربية؟ سنكمل في مواضيع قادمة من سلسلة تطوير تطبيقات الذكاء الاصطناعي بشرح قواعد البيانات المتجهة بالتفصيل.
