
ربما شاهدت نموذجًا مفتوح المصدر قويًا وقرأت أنه يحتاج إلى 140 جيجابايت من ذاكرة كرت الشاشة، فقلت في نفسك: هذا ليس لي. لكن الحقيقة أن معظم من يشغلون النماذج على أجهزتهم الشخصية لا يستخدمون النسخة الأصلية، بل نسخة مضغوطة بفضل تقنية Quantization أو التكميم. هذه التقنية هي السبب في أنك تستطيع اليوم تشغيل نموذج كان يتطلب سيرفرًا كاملًا على حاسوب ألعاب عادي أو جهاز ماك محمول. في هذا الشرح سنفهم كيف تعمل، وما معنى الرموز الغريبة مثل Q4_K_M، وكيف تختار المستوى المناسب لجهازك.
التشبيه الأقرب هو ضغط الصور؛ فالصورة الأصلية بصيغة RAW قد يبلغ حجمها 50 ميجابايت، ونسخة JPEG بجودة عالية قد تكون 5 ميجابايت، ومعظم الناس لا يلاحظون الفرق. بالطريقة نفسها، النموذج المكمّم بمستوى 4 بت يأخذ ربع الحجم تقريبًا، ويحتفظ في أغلب المهام بمعظم جودته الأصلية.
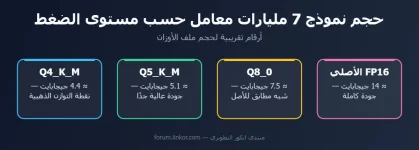
والقاعدة التي توصلت إليها التجارب في المجتمع المفتوح أن مستوى Q4_K_M هو نقطة التوازن الذهبية لمعظم المستخدمين، بينما يعطي Q5 وQ6 جودة أقرب للأصل مع حجم أكبر، ويبقى Q8 شبه مطابق للأصل تقريبًا. أما المستويات الأقل من 4 بت مثل Q3 وQ2 فتبدأ الجودة عندها بالتراجع بشكل ملحوظ، خصوصًا في المهام التي تحتاج إلى دقة مثل البرمجة والرياضيات، وقد يلاحظ المستخدم العربي ضعفًا في جودة اللغة قبل غيره لأن العربية أقل حضورًا في بيانات التدريب.
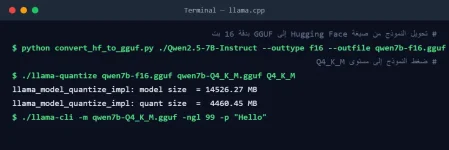
وفي أغلب الأحيان لن تحتاج إلى ضغط النموذج بنفسك، لأن مجتمع Hugging Face يرفع نسخًا مكممة جاهزة لكل نموذج شهير بمختلف المستويات. لكن إن أردت التجربة، فهذا ما تبدو عليه العملية باستخدام أداة llama.cpp:
وهنا نقطة يغفل عنها كثيرون: نموذج أكبر بمستوى Q4 يتفوق غالبًا على نموذج أصغر بمستوى Q8 في الجودة مع حجم ملف متقارب. لذلك إذا كنت مخيرًا بين الاثنين، فجرّب النموذج الأكبر المضغوط أولًا. كما أن تقنيات مثل تكميم ذاكرة السياق نفسها (KV Cache) تتيح لك سياقًا أطول على الذاكرة نفسها.
ما هي تقنية Quantization ببساطة؟
النموذج اللغوي في جوهره مجموعة ضخمة من الأرقام تسمى الأوزان، قد تصل إلى مليارات الأرقام. في النسخة الأصلية يُخزن كل رقم عادة بدقة 16 بت، أي أن نموذجًا بحجم 7 مليارات معامل يحتاج تقريبًا إلى 14 جيجابايت لتخزين الأوزان وحدها. فكرة تقنية Quantization هي تخزين كل رقم بعدد أقل من البتات، مثل 8 أو 4 بت، مع قبول خسارة صغيرة في الدقة.التشبيه الأقرب هو ضغط الصور؛ فالصورة الأصلية بصيغة RAW قد يبلغ حجمها 50 ميجابايت، ونسخة JPEG بجودة عالية قد تكون 5 ميجابايت، ومعظم الناس لا يلاحظون الفرق. بالطريقة نفسها، النموذج المكمّم بمستوى 4 بت يأخذ ربع الحجم تقريبًا، ويحتفظ في أغلب المهام بمعظم جودته الأصلية.
لماذا لا تنهار جودة النموذج مع الضغط؟
السبب أن الأساليب الحديثة لا تضغط كل الأوزان بالطريقة نفسها. فهي تقسم الأوزان إلى مجموعات صغيرة، ولكل مجموعة معامل تحجيم خاص يحافظ على نطاق قيمها، كما أن بعض الطبقات الحساسة في النموذج تُحفظ بدقة أعلى من غيرها. وهذا ما تعنيه الحروف في أسماء الملفات: فالرقم بعد حرف Q يشير إلى متوسط عدد البتات، وحرف K يعني استخدام أسلوب k-quants الذي يمزج مستويات دقة مختلفة بذكاء، والحرف الأخير S أو M أو L يشير إلى حجم هذا المزيج من الأصغر إلى الأكبر.والقاعدة التي توصلت إليها التجارب في المجتمع المفتوح أن مستوى Q4_K_M هو نقطة التوازن الذهبية لمعظم المستخدمين، بينما يعطي Q5 وQ6 جودة أقرب للأصل مع حجم أكبر، ويبقى Q8 شبه مطابق للأصل تقريبًا. أما المستويات الأقل من 4 بت مثل Q3 وQ2 فتبدأ الجودة عندها بالتراجع بشكل ملحوظ، خصوصًا في المهام التي تحتاج إلى دقة مثل البرمجة والرياضيات، وقد يلاحظ المستخدم العربي ضعفًا في جودة اللغة قبل غيره لأن العربية أقل حضورًا في بيانات التدريب.
صيغ تقنية Quantization الأكثر استخدامًا
الصيغة الأشهر للمستخدمين المنزليين هي GGUF التي تعتمد عليها أدوات مثل llama.cpp وOllama وLM Studio، وميزتها أنها تعمل على كرت الشاشة والمعالج معًا، فإذا لم تتسع ذاكرة الكرت للنموذج كاملًا تُحمّل بعض الطبقات على الذاكرة العادية، وتستمر في العمل بسرعة أقل. وهناك صيغ مخصصة لكروت الشاشة مثل GPTQ وAWQ وEXL2 تعطي سرعة أعلى حين يتسع النموذج كاملًا في ذاكرة الكرت، وصيغة MLX لأجهزة ماك بمعالجات Apple.وفي أغلب الأحيان لن تحتاج إلى ضغط النموذج بنفسك، لأن مجتمع Hugging Face يرفع نسخًا مكممة جاهزة لكل نموذج شهير بمختلف المستويات. لكن إن أردت التجربة، فهذا ما تبدو عليه العملية باستخدام أداة llama.cpp:
كيف تختار حجم النموذج ومستوى الضغط لجهازك؟
القاعدة التقريبية أن حجم ملف النموذج المكمّم يجب أن يكون أقل من ذاكرة كرت الشاشة بحوالي 1 إلى 2 جيجابايت، لأنك تحتاج إلى مساحة إضافية لذاكرة السياق التي تكبر كلما طالت المحادثة. فإذا كان لديك كرت بذاكرة 8 جيجابايت، فنموذج بحجم 7 أو 8 مليارات معامل بمستوى Q4_K_M أو Q5_K_M خيار مريح. ومع 12 جيجابايت يمكنك تشغيل نماذج بحجم 12 إلى 14 مليار معامل بمستوى 4 بت. أما مع 24 جيجابايت فتنفتح أمامك نماذج بحجم 30 مليار معامل تقريبًا.وهنا نقطة يغفل عنها كثيرون: نموذج أكبر بمستوى Q4 يتفوق غالبًا على نموذج أصغر بمستوى Q8 في الجودة مع حجم ملف متقارب. لذلك إذا كنت مخيرًا بين الاثنين، فجرّب النموذج الأكبر المضغوط أولًا. كما أن تقنيات مثل تكميم ذاكرة السياق نفسها (KV Cache) تتيح لك سياقًا أطول على الذاكرة نفسها.
